xcx-ml
機械学習 (xcx-ml)
カメラの画像やマイクの音を機械学習で認識する Xcratch 用拡張機能です。 学習済みモデル (画像: MobileNet v2 alpha=0.5、音: speech-commands) の特徴量を KNN 分類器で分類する転移学習方式なので、数枚の画像や数回の音を学習させるだけですぐに認識できます。
使い方
Xcratch の「拡張機能を読み込む」で次の URL を指定してください。
https://asondemita.github.io/xcx-ml/dist/xcx-ml.mjs
サンプルプログラム
ジャンケン(グー・チョキ・パー)を認識するサンプル examples/sample.sb3 を使って、基本的な使い方を説明します。
次のリンクをクリックすると、サンプルを Xcratch で直接開けます。
1. 緑の旗をクリック
カメラ画像がステージに表示されます(初回はブラウザがカメラの使用許可を求めてきます)。
2. ラベルの学習
ジャンケンを学習します(ラベル1=グー/ラベル2=チョキ/ラベル3=パー)。
- a. カメラにグーが映る状態にして「ラベル1を学習する」をクリックします。ステージ左上の「機械学習: ラベル」が 1 になるまで何回もクリックします。
- b. カメラにチョキが映る状態にして「ラベル2を学習する」を「機械学習: ラベル」が 2 になるまでクリックします。
- c. カメラにパーが映る状態にして「ラベル3を学習する」を「機械学習: ラベル」が 3 になるまでクリックします。
初回のクリック時は「環境構築に少し時間がかかります…」と表示され、動き出すまで少し待ちます(約9MBのダウンロードが発生します)。
3. 学習の確認
カメラにグー/チョキ/パーを見せると、ラベルが 1/2/3 と変わればOKです。
- ※うまく変わらない時: 例えばチョキがうまく判定できない時は、チョキをカメラに見せて、ラベルが 2 になるまで「ラベル2を学習する」を何度もクリックします(追加学習)。
- ※間違えた場合: 「学習をリセット」をクリックして始めから行ってください。
4. 学習したデータを活用
例: チョキを出した時にニャーと鳴くプログラム
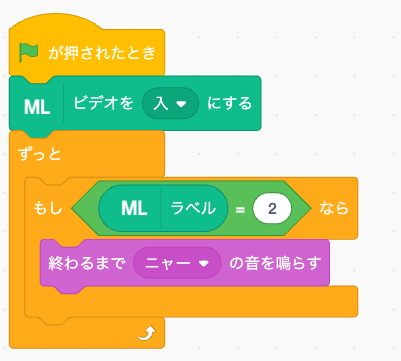
うまく学習できた内容は「学習データを保存」でファイルに保存しておき、次回は「学習データを読み込む」で復元すると、学習し直さずにすぐ使えます。
音を認識する
「入力を[マイク]にする」ブロックを実行すると、それ以降の「ラベル1を学習する」「ラベル」などのブロックはカメラ画像のかわりにマイクの音を扱います。ブロックの使い方は画像のときと同じです。
- 「入力を[マイク]にする」をクリックします(初回はブラウザがマイクの使用許可を求めてきます)。
- 「ラベル1を学習する」をクリックすると「マイクの音を聞いています…」と残り時間のゲージが表示されるので、ゲージが赤く埋まるまでの約2秒の間に音(拍手・口笛・「あ」の声など)を出します。「終了」と表示されたら学習完了です。ラベルごとに何回か繰り返します。
- 「ラベル」は直近約1秒の音を分類した結果を返します。何も音を出していない状態を「ラベル3」などとして学習しておくと、静かなときの誤判定を減らせます。
「入力を[カメラ]にする」でカメラ画像の認識に戻ります(マイクは停止します)。画像の学習内容と音の学習内容は別々に保持され、「学習データを保存」「学習データを読み込む」は両方をまとめて扱います。「学習をリセット」も両方を消去します。
ブロック
| ブロック | 種類 | 説明 |
|---|---|---|
| ラベル1を学習する | コマンド | 現在のカメラ画像 (マイク入力のときはこれから約2秒の音) をラベル1の例として学習する |
| ラベル2を学習する | コマンド | 同上 (ラベル2) |
| ラベル3を学習する | コマンド | 同上 (ラベル3) |
| ラベル | 値 | 現在のカメラ画像 (マイク入力のときは直近約1秒の音) を分類したラベルを返す (未学習のときは空) |
| 学習をリセット | コマンド | 学習した例 (画像・音の両方) をすべて消去する |
| 学習データを保存 | コマンド | 学習内容 (画像・音の両方) を JSON ファイルとしてダウンロードする |
| 学習データを読み込む | コマンド | JSON ファイルから学習内容を復元する |
| 入力を[カメラ/マイク]にする | コマンド | 学習・認識の入力をカメラ画像とマイクの音で切り替える (初期値はカメラ) |
| ビデオを[入/切]にする | コマンド | ステージのビデオ表示とカメラを制御する |
特徴
- TensorFlow.js / モデル / KNN 分類器は 最初に ML ブロックを使ったときにロード します。拡張を追加しただけではメモリをほとんど消費せず、カメラもマイクも起動しません。
- 分類は「ラベル」ブロックが評価されたときだけ実行します (常時分類ループなし)。
- 推論のたびに生成されるテンソルを毎回解放するため、長時間使ってもメモリが増え続けません。
- 画像の特徴抽出は MobileNet v2 (alpha=0.5) で、モデルサイズは約 7.5MB です。音の特徴抽出は TensorFlow.js speech-commands の学習済みモデル (browser_fft, 18 words) の隠れ層出力で、モデルサイズは約 5.6MB です。モデルの入力は約1秒分の音なので、学習時は約2秒の録音を0.5秒ずつずらした1秒の窓3つに切り出し、それぞれを例として学習します。
- ライブラリとモデルはこの拡張機能と同じ
asondemita.github.ioから配信します (CDN や TensorFlow Hub には接続しません)。
初回の ML ブロック実行時に約 9MB (画像) または約 7MB (音) のダウンロードが発生します (要インターネット接続)。
開発
# 隣のディレクトリに xcratch/scratch-gui が必要です
npm run register   # scratch-gui に拡張を登録
npm run start      # 開発サーバー (http://localhost:8601)
npm run build      # dist/xcx-ml.mjs をビルド
バージョンは package.json の version で管理します。ビルド時に scripts/generate-version.js が src/gui/lib/libraries/extensions/entry/version.js を生成し、Xcratch の拡張機能一覧の説明文の末尾に「(vX.Y.Z)」として表示されます。
ライセンス
MIT